Balso agentą NVIDIA leidžia paleisti savo kompiuteryje
Atviras NVIDIA Nemotron Voice Agent sujungia kalbos atpažinimą, atsakymų kūrimą ir balso sintezę. Vietiniam Bolt E4B variantui nurodoma bent 24 GiB tinkamos atminties.
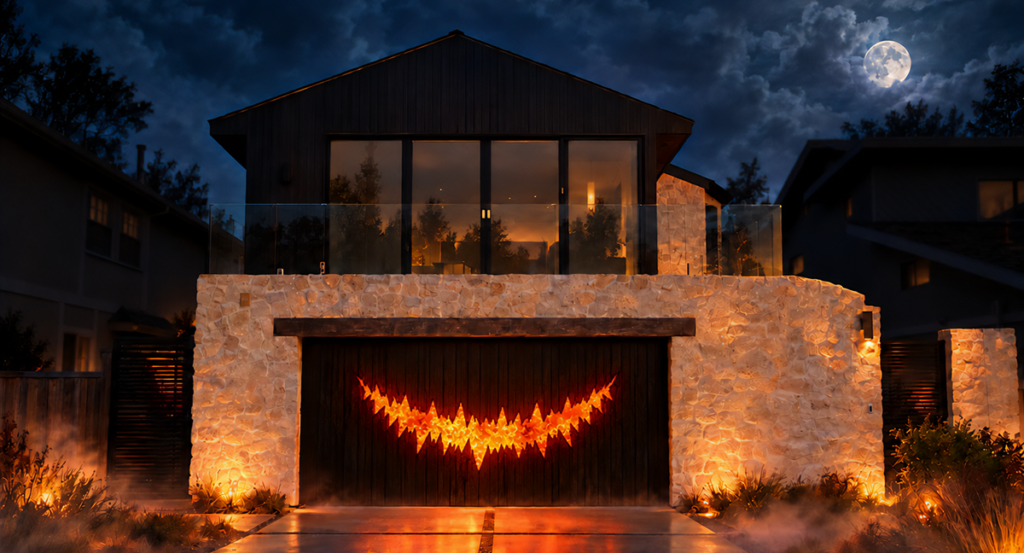
NVIDIA atviras Nemotron Voice Agent leidžia sujungti kalbos atpažinimą, kalbos modelį ir balso sintezę į vieną vietoje veikiantį asistentą. Spalio 30 dieną NVIDIA darbuotojas Rick Grandy Hugging Face pristatė šiuo pagrindu sukurtą kalbantį namą, kartu nurodydamas viešai prieinamus naudojamus modelius.
Oficialioje projekto GitHub saugykloje NVIDIA pateikia balso agento kodą ir kelis pavyzdžius, skirtus skirtingoms užduotims bei įrangai. Projektas remiasi Pipecat sistema, o jo dalis galima keisti atskirai: nuo garsą atpažįstančio modelio iki atsakymus kuriančio modelio ir kalbos sintezatoriaus.
Pagal saugyklos LICENSE dokumentą, programinis kodas platinamas su Apache 2.0 licencija, o dokumentacijai ir papildomai medžiagai taikoma CC BY 4.0. Tai nėra pažadas, kad visi prijungiami modeliai ar išorinės paslaugos turi identiškas sąlygas: jų naudojimą apibrėžia atskirai pateikiamos licencijos.
NVIDIA dokumentacijoje išskiriami debesijos, serverio ir vienos vaizdo plokštės paleidimo variantai, kurių aparatūros poreikiai reikšmingai skiriasi pagal pasirinktus modelius bei darbo apkrovą. Vietiniam Bolt E4B variantui nurodoma bent 24 GiB naudojamos atminties palaikomoje darbo stoties vaizdo plokštėje, DGX Spark arba Jetson Thor.
Numatytajam serverio variantui, kai visi NIM komponentai veikia vienoje vaizdo plokštėje, projekto aprašyme nurodoma maždaug 80 GB atminties. Debesijos variantui vietinės vaizdo plokštės nereikia, tačiau modeliai tuomet pasiekiami per NVIDIA paslaugas, todėl tai nėra toks pats visiškai vietinis vykdymas.
Programinės įrangos reikalavimuose NVIDIA nurodo Docker Compose 2.20 arba naujesnį leidimą ir vietiniams variantams tinkamai sukonfigūruotą vaizdo plokštės palaikymą. Vienos vaizdo plokštės profiliui reikia Hugging Face prieigos rakto modeliams atsisiųsti ir bent 580 serijos NVIDIA tvarkyklės, o debesijos bei serverio prieigos sąlygos skiriasi.
Grandy aprašytame MonsterHouse eksperimente klausymą, atsakymų kūrimą ir kalbėjimą papildo veido animacija, todėl jo demonstracijoje panaudotos dvi profesionalios vaizdo plokštės. Pasak autoriaus, kalbos grandinė veikė RTX PRO 6000 Blackwell Max-Q, o Unreal Engine vaizdas ir Audio2Face-3D animacija naudojo RTX PRO 4000 Blackwell.
Autorius nurodo išmatavęs 1,70 sekundės medianinį laiką nuo kalbos pabaigos iki garso atsakymo naudojant Bolt ir gyvą balso sintezę. Iš anksto parengtiems atsakymams rodiklis siekė 0,72 sekundės, tačiau tai konkrečios demonstracijos matavimai, o ne visiems kompiuteriams garantuojama sparta.
GitHub aprašyme pateikiami ir kelių kalbų, vaizdinės informacijos bei atskirų priekinio ir užduotis vykdančio agento komponentų pavyzdžiai skirtingiems scenarijams. NVIDIA nurodo, kad pagrindinis Generic Assistant pavyzdys skirtas anglų kalbai, todėl jo nereikėtų automatiškai pristatyti kaip jau parengto lietuviškai kalbančio asistento.
Grandy aiškiai pažymi, kad visas MonsterHouse kodas dar neparengtas viešam leidimui, nors pagrindinis NVIDIA balso agentas jau prieinamas atskirai. Toliau autorius planuoja bandymus su tikrais lankytojais ir naktiniu apšvietimu; dabartinis demonstravimas dar nepatvirtina patikimo savarankiško veikimo visą renginio vakarą.
Rašome apie dirbtinį intelektą lietuviškai. Kiekvienas straipsnis parengtas pagal nurodytą šaltinį, o nuorodą į originalą rasite kortelėje „Šaltinis“.