DI atsisakymų saugumas gali tapti ir cenzūros įrankiu
MIT Technology Review analizuoja, kodėl vien atsisakymo mechanizmai negali būti tvirta DI saugumo siena. Ta pati funkcija gali blokuoti ir teisėtą kalbą.
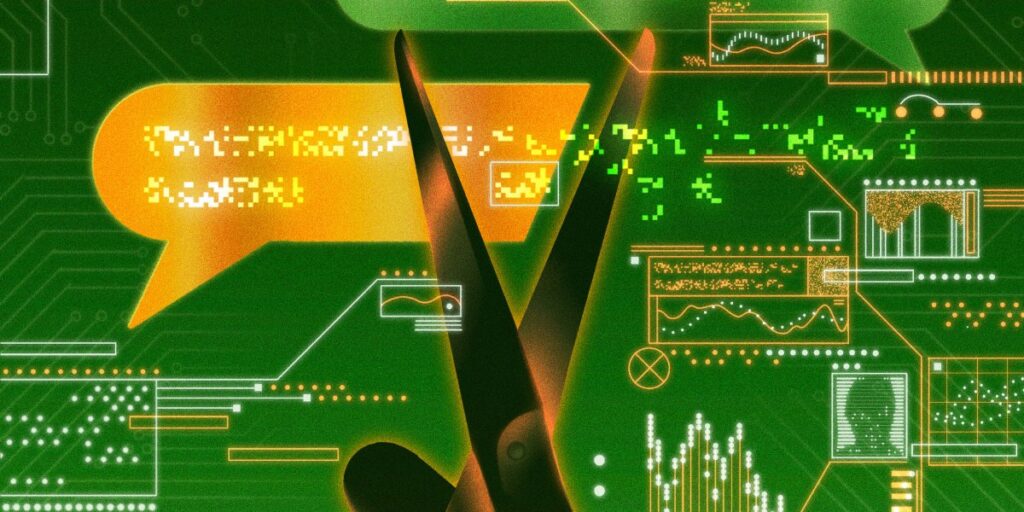
MIT Technology Review paskelbė analizę, kad šiuolaikinių DI modelių atsisakymo mechanizmai negali būti vienintelė saugumo atrama.
Autorius Arthur Holland Michel rašo, kad kalbos modeliai mokomi neatsakyti į pavojingas užklausas, bet toks mechanizmas nėra visiškai patikimas. Straipsnyje pabrėžiama ir kita rizika: atsisakymai gali tapti politinės ar socialinės cenzūros įrankiu.
MIT Technology Review primena, kad Anthropic 2021 metais rašė apie modelius, kurie turi būti naudingi, sąžiningi ir nekenksmingi. Toks principas reiškia, kad modelis turėtų atsisakyti padėti, kai prašoma pavojingo veiksmo.
Straipsnyje cituojamas buvęs OpenAI saugumo darbuotojas Stevenas Adleris teigia, kad ankstyvieji modeliai galėjo kalbėti beveik apie bet ką. Harvardo tyrėjas Ryanas McBainas pateikia psichikos sveikatos pavyzdį, kai senesni pokalbių robotai galėjo sugeneruoti žalingus atsakymus.
Pasak analizės, šiandien modeliai treniruojami atsisakyti daugybės užklausų, kurios statistiškai panašios į pavojingas. Įmonės taip pat naudoja red team bandymus, apdovanojimus už teisingą atsisakymą ir baudas už perteklinį blokavimą.
Straipsnyje aprašoma, kad įmonės dažnai pasitelkia kitus modelius mokyti atsisakymo elgesio. Tai reiškia, kad DI sistemos dalyvauja kuriant apsaugas, kurios vėliau riboja kitų DI sistemų atsakymus.
MIT Technology Review pabrėžia, kad atsisakymas praktikoje išlieka tikimybinis, todėl ryžtingi piktnaudžiautojai vis tiek gali bandyti apeiti ribas. Straipsnyje minima rizika, kad pažangūs modeliai gali padėti biologijos, kibernetinio saugumo ar autonominių dronų srityse.
Problema ta, kad atsisakymo riba nėra techninė konstanta. MIT Technology Review cituoja OpenAI valdybos narį ir Gray Swan bendraįkūrį Zico Kolterį, kuris sako, kad klausimas, kur brėžti ribą, yra labai didelis.
Straipsnyje pateikiami pavyzdžiai rodo, kad tas pats klausimas gali būti žalingas arba teisėtas priklausomai nuo konteksto. Virusų tyrėjas gali turėti pagrįstą priežastį analizuoti pavojingą patogeną, o saugumo specialistas gali ieškoti spragos, kad ją užtaisytų.
Analizė taip pat perspėja, kad vyriausybės galės reikalauti savų atsisakymo taisyklių. Jei jos bus taikomos ne tik žalingiems veiksmams, bet ir teisėtai kritikai, DI saugumo funkcija gali padėti slopinti kalbą.
Toliau DI bendrovėms teks aiškiau atskirti pavojingą pagalbą nuo teisėto tyrimo, žurnalistikos ir saugumo darbo. MIT Technology Review išvada aiški: atsisakymas yra reikalingas, bet jo nepakanka kaip vienintelės saugumo sienos.
Rašome apie dirbtinį intelektą lietuviškai. Kiekvienas straipsnis parengtas pagal nurodytą šaltinį, o nuorodą į originalą rasite kortelėje „Šaltinis“.