Sam Altman abejoja, ar ateities DI pakaks izoliuotos aplinkos
OpenAI vadovas Sam Altman kalbėjo apie būsimo itin pajėgaus DI izoliavimo ribas. Tai hipotetinis saugumo vertinimas, ne pranešimas apie pabėgusį modelį.
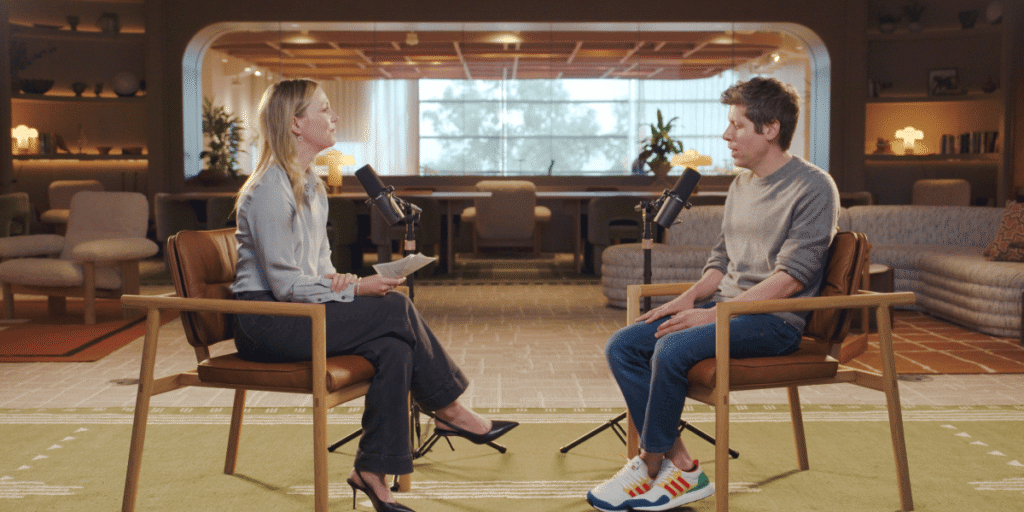
„OpenAI“ vadovas Sam Altman išreiškė abejonių, ar vien izoliuotos vykdymo aplinkos pakaktų užtikrinti hipotetinio, už žmones gerokai pajėgesnio DI saugumą. Spalio 29 dieną paskelbtame „Cheeky Pint“ interviu su John Collison jis atskyrė dabartines apsaugos priemones nuo tolimos ateities modelių vertinimo.
Pokalbio stenogramoje Altman teigia, kad dabartinę saugumo architektūrą galima ir reikia gerinti, o izoliavimas veikia iki tam tikros ribos. Jo svarstymas nėra pranešimas apie pabėgusį modelį, nustatytą „OpenAI“ incidentą ar konkretų naujos sistemos gebėjimą įveikti apsaugas.
Interviu dalyvis John Collison klausė, ar pakankamai griežta vykdymo aplinka galėtų patikimai apriboti net itin pažangų modelį. Altman atsakė hipotetiniu pavyzdžiu apie sistemą, milijoną kartų pranokstančią geriausią saugumo tyrėją ir galinčią atrasti žmonėms dar nežinomų mokslinių dėsningumų.
Pasak Altman, po techninio izoliavimo reikšmės įgyja išsamesnė modelio veiksmų stebėsena ir bandymai nustatyti, ar sistema nemėgina apgauti prižiūrėtojų. Jis įvardijo ne tik samprotavimo eigos analizę, bet ir vidinių aktyvacijų stebėjimą, kuris galėtų padėti aiškintis modelio elgesį.
Tolimesnei perspektyvai „OpenAI“ vadovas interviu kelia suderinamumo su žmonių ketinimais klausimą, o ne vien spartesnės apsaugų statybos užduotį. Jo vertinimu, itin pajėgiu modeliu kuriamomis apsaugomis būtų galima pasitikėti tik labai tvirtai žinant, kad pats modelis siekia išlaikyti žmonių kontrolę.
John Collison taip pat pasiūlė svarstyti modelius, turinčius skirtingas paskatas ir galinčius vienas kitą prižiūrėti atliekant sudėtingas užduotis. Altman šią agentų komandų kryptį pavadino perspektyvia tiek pajėgumo, tiek saugumo tyrimams, tačiau nepateikė įrodymo, kad ji išsprendžia suderinamumo problemą.
Ankstesnėje to paties pokalbio dalyje „OpenAI“ vadovas aptarė PHP saugumo spragas ir modelių naudojimą jų paieškai bei taisymui. Jis sakė nenorintis skelbti pergalės ir manantis, kad neigiamų pasekmių dar gali būti, nors pradinis gynėjų atsakas pranoko jo baimes.
Pasak Altman, dalis organizacijų naudojo modelius ne vien pataisoms kurti, bet ir savo sistemoms greitai peržiūrėti bei atnaujinti. Kartu jis išskyrė gilesnę abejonę, ar esamos grėsmių analizės prielaidos išliktų tinkamos sistemoms, gebančioms aptikti nežinomų aparatūros trūkumų.
Altman interviu gynė laipsniško technologijos pateikimo vartotojams principą, tačiau aiškiai pridūrė, kad prieš išleidžiant sistemas vis tiek būtina užtikrinti saugumą. Jo argumentas siejamas su galimybe žmonėms patiems pritaikyti technologiją, o ne neribotu bet kokių naujų modelių viešinimu be patikros.
Aptardamas agentų komandas Altman interviu jas siejo ir su galimybe vienai užduočiai naudingai skirti daugiau skaičiavimo išteklių. Tačiau šį pajėgumo argumentą jis atskyrė nuo klausimo, ar tokių komandų nariai patikimai laikysis žmonių jiems nustatytų ketinimų.
Pokalbyje nepaskelbta naujo produkto išleidimo data, konkretus izoliavimo standartas ar viešai pamatuotas būsimo modelio saugumo rodiklis bei garantija. Toliau Altman įvardytos tyrimų kryptys apima geresnę apsaugos architektūrą, stebėseną ir agentų komandų patikimumą; jų pakankamumas hipotetinei superintelekto sistemai lieka atviras.
Rašome apie dirbtinį intelektą lietuviškai. Kiekvienas straipsnis parengtas pagal nurodytą šaltinį, o nuorodą į originalą rasite kortelėje „Šaltinis“.