Milijoną procesorių Meta numato plečiamame Prometheus klasteryje
Meta užbaigė pirmą Prometheus DI infrastruktūros etapą ir jame mokė Muse modelius. Galutinis masto tikslas siekia maždaug milijoną grafikos procesorių.
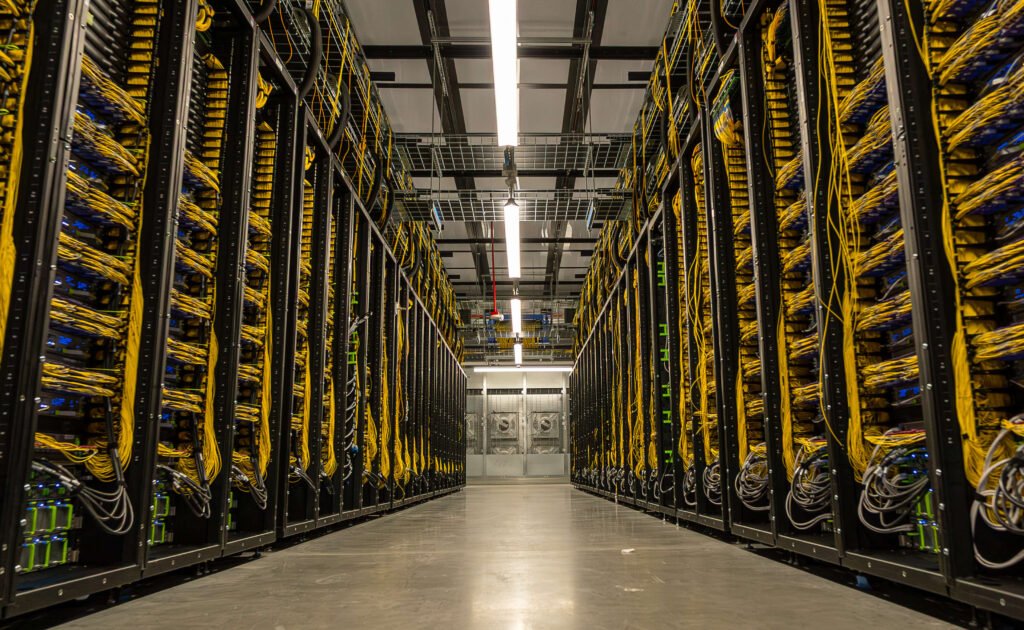
Meta užbaigė pirmą Prometheus DI skaičiavimo klasterio etapą ir planuoja visą sistemą išplėsti iki maždaug milijono tarpusavyje veikiančių grafikos procesorių. Spalio 19 dienos inžinierių publikacijoje bendrovė nurodo, kad pirmuoju etapu jau mokyti jos Muse šeimos modeliai, įskaitant Muse Wonder.
Pasak Meta, New Albany mieste Ohajo valstijoje kuriama infrastruktūra dabar jungia šimtus tūkstančių procesorių keliuose pastatuose į vieną bendrą sistemą. Milijonas procesorių yra būsimo pilno masto tikslas, todėl šio skaičiaus negalima laikyti dabartinės jau įjungtos įrangos kiekiu šiandien.
Bendrovė aiškina, kad toje vietoje prieš dvejus metus veikė įprasta interneto paslaugų duomenų centro infrastruktūra, vėliau pertvarkyta modelių mokymui. Nauji mokymo darbai reikalauja glaudaus procesorių darbo derinimo, todėl vieno įrenginio gedimas gali sustabdyti arba sulėtinti didesnį bendrą skaičiavimą.
Meta skelbia Muse Wonder mokymo metu pasiekusi daugiau nei 85 procentų naudingo darbo rodiklį pradiniame mokyme ir daugiau nei 90 procentų pastiprinamajame mokyme. Tai pačios bendrovės infrastruktūros efektyvumo matas, o ne naujas modelio atsakymų tikslumo testas ar naudotojui garantuojamas paslaugos prieinamumas.
StorageReview apžvalgoje detalizuojamos dvi naudojamos Nvidia platformos: GB200 pagrįsta Catalina ir GB300 pagrįsta Clemente, pritaikytos glaudžiai sujungtiems procesoriams. Leidinys pažymi, kad NVL72 architektūroje 72 procesoriai sudaro vieną glaudžiai susietą darbo sritį, todėl jos patikimumas tampa ypač svarbus.
StorageReview aprašo, kaip Meta kiekvienoje tokioje srityje mokymo darbui naudoja 64 procesorius, o likusius aštuonis laiko atsarginiais gedimams pakeisti. Šis sprendimas leidžia greičiau atnaujinti darbą nuo išsaugotos būsenos, užuot visą užduotį siejus su sugedusio įrenginio fizinio remonto trukme.
Leidinio pateikiamame pavyzdyje 32 768 aktyvių procesorių mokymo darbui suplanuojamos 523 spintos su iš viso 37 656 procesoriais, įskaitant rezervą. Skirtumas tarp aktyvaus ir bendro įrenginių skaičiaus parodo, kodėl didelio klasterio apimtis savaime nepasako, kiek lustų vienu metu mokys vieną modelį.
Pasak StorageReview, pastatus jungiantis tinklas turi aptarnauti koordinuotą mokymą ne tik viename koridoriuje, bet ir didesniais atstumais tarp infrastruktūros objektų. Apžvalgoje pabrėžiamas tinklo, atsarginių įrenginių ir aušinimo derinimas: didesnis įrenginių skaičius be šių sistemų nepaverčiamas lygiaverčiu naudingu skaičiavimo laiku.
StorageReview aprašo ir skirtingą spintų elektrinę apkrovą: GB200 platformos dviejų spintų porai nurodoma maždaug 120 kilovatų, GB300 spintai – apie 135 kilovatus. Šie skaičiai taikomi konkrečioms įrangos konfigūracijoms, o ne visos teritorijos sunaudojimui, todėl jų nereikėtų painioti su galutiniu gigavatų masto klasterio tikslu.
Meta savo publikacijoje teigia, kad tolesnė Prometheus plėtra ruošiama būsimiems Meta Superintelligence Labs modeliams, tačiau tikslios milijono procesorių pasiekimo datos nepateikia. Kitas etapas apims didesnį mastą ir naują įrangą; dabartinis pranešimas pirmiausia atskleidžia jau atlikto mokymo infrastruktūrą, o ne naują vartotojų produktą.
Rašome apie dirbtinį intelektą lietuviškai. Kiekvienas straipsnis parengtas pagal nurodytą šaltinį, o nuorodą į originalą rasite kortelėje „Šaltinis“.