Beveik 300 terabaitų robotų duomenų LeRobot leis mokyti neatsisiuntus
LeRobot 0.7.0 leidžia mokyti robotų modelius skaitant duomenis tiesiai iš saugyklų. Atviro kodo projektas taip pat prideda sąveiką kalba ir nuotolinį skaičiavimą.
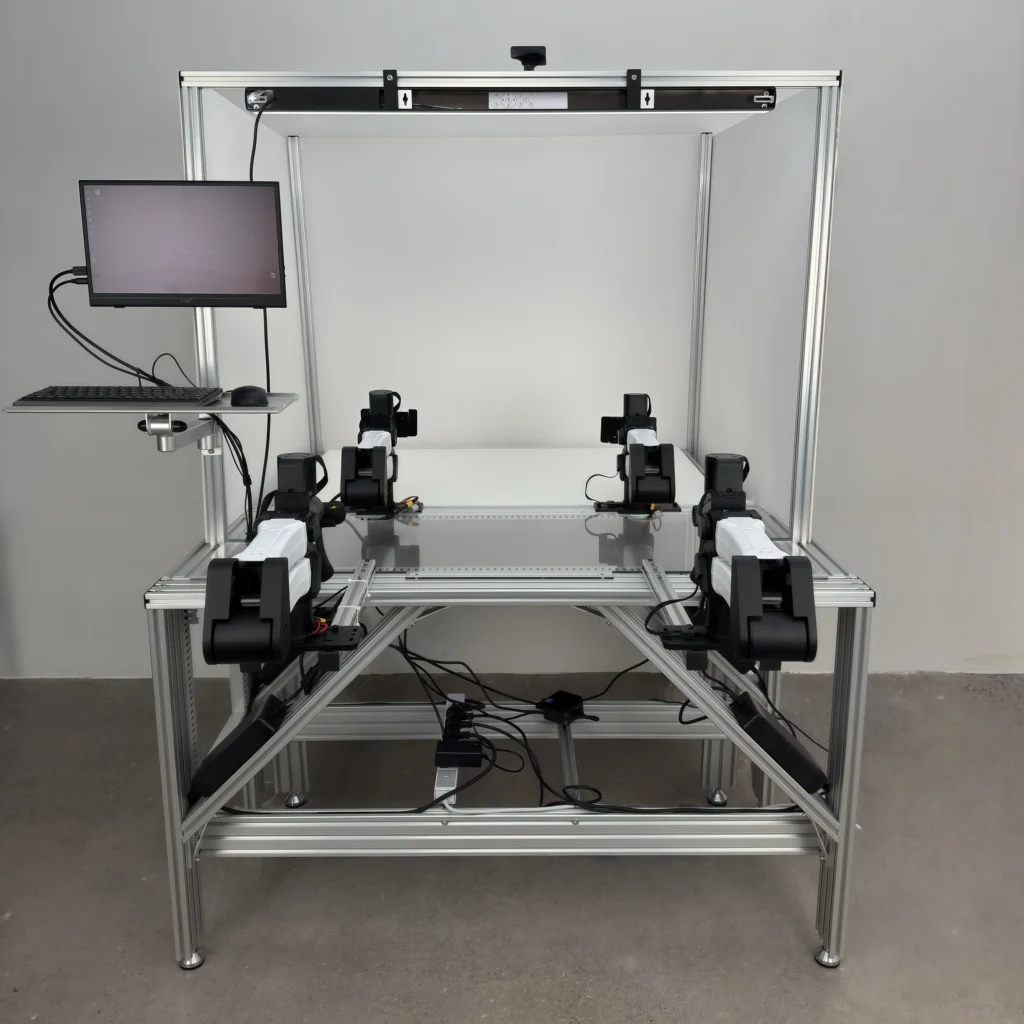
Beveik 300 terabaitų atvirų robotikos duomenų sukaupęs Hugging Face LeRobot projektas pristatė 0.7.0 leidimą su mokymu tiesiai iš internetinių saugyklų. Lapkričio 5 dienos kūrėjų pranešime nurodoma, kad viso duomenų rinkinio nebereikia iš anksto parsisiųsti į mokymo kompiuterio diską.
LeRobot kuria Hugging Face komanda ir bendruomenės dalyviai, o projekto paskirtis yra bendri robotų modelių, duomenų ir valdymo įrankiai. GitHub saugykloje skelbiamas kodas platinamas pagal Apache 2.0 licenciją; saugyklos licencijos faile atskirai išvardijami ir perimtų komponentų leidimai.
Pasak kūrėjų, naujas skaitytuvas iš Hub ar Storage Bucket paima tik mokymui reikalingas vaizdo failų baitų atkarpas, neužimdamas disko visu rinkiniu. Komanda nurodo, kad panaudojus keturis duomenų įkėlimo procesus bandymuose per sekundę apdorotų pavyzdžių kiekis padidėjo nuo 2,1 iki 2,5 karto.
Leidimas taip pat leidžia keisti roboto užduotį veikimo metu, klausti, ką modelis mato, arba paskirti jam bendresnį tikslą. Hugging Face paaiškina, kad klausimams ir savarankiškam smulkesnių užduočių parinkimui reikalingas tekstą generuojantis robotikos modelis arba atskiras vaizdo ir kalbos planuotojas.
Kaip tokio darbo pavyzdį komanda pateikia kartu su Scale AI parengtą FineART rinkinį, kuriame yra daugiau kaip 40 tūkstančių dviejų rankų demonstracijų. Pranešime nurodoma 1 718 valandų įrašų ir daugiau kaip 533 tūkstančiai smulkesnių užduočių žymų, leidžiančių sieti veiksmus su kalbiniais aprašymais.
Naujajame leidime didesnio modelio skaičiavimą galima perkelti į nuotolinį GPU serverį, o pačiame robote palikti mažesnius skaičiavimo reikalavimus, nurodo kūrėjai. Tai nėra pažadas, kad visi modeliai tilps nešiojamame kompiuteryje: įrangos poreikiai priklauso nuo pasirinkto modelio, mokymo būdo ir paties roboto.
Hugging Face pateikia dideliems modeliams skirtą bandymą su aštuoniomis H200 vaizdo plokštėmis ir šešių milijardų parametrų FastWAM modeliu. Jame naujas mokymo būsenos išsaugojimas buvo tris kartus spartesnis, o didžiausias atminties poreikis atnaujinant darbą sumažėjo nuo 143 iki 42 gigabaitų vienai plokštei.
Pasak Hugging Face, leidime taip pat įdiegtas atviro kodo Trackio bandymų stebėjimas, leidžiantis sekti vietinius mokymo darbus nesiregistruojant paslaugoje. Prisijungimo reikia tik tuomet, kai rezultatų duomenys sinchronizuojami į Hugging Face Space, nurodo projekto komanda.
Projekto README nurodo Python ir PyTorch pagrindą bei atskirus duomenų, mokymo ir konkrečios robotų įrangos komponentus, todėl bandymui reikia pasirinkti atitinkamą aplinką. Tarp palaikomų įrenginių yra SO-101, Unitree G1 ir reBot B601, o naujajame leidime papildomai aprašytas YAM manipuliatorių palaikymas.
Kodas, modelių nuorodos ir dokumentacija jau pateikti viešai, todėl tyrėjai gali rinktis konkretų duomenų rinkinį ir su juo suderinamą valdymo modelį. Kūrėjai praneša toliau plėsiantys bendruomenės modelių, duomenų ir robotų integracijas; atskirų naujų integracijų terminai šiame leidimo pranešime nepateikti.
Rašome apie dirbtinį intelektą lietuviškai. Kiekvienas straipsnis parengtas pagal nurodytą šaltinį, o nuorodą į originalą rasite kortelėje „Šaltinis“.